FeynmanWiki
ExploreLibraryRoadmapsCreateMy blogsPricing
← All roadmaps
Language Models

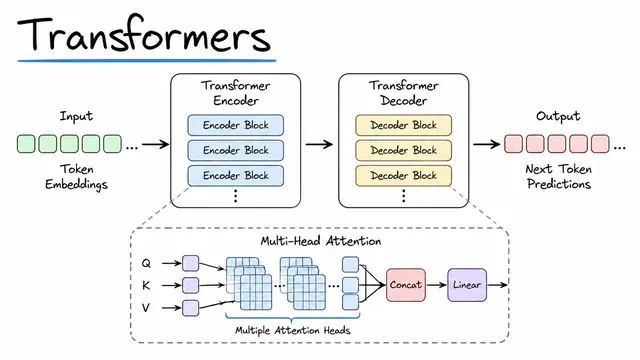
Transformers from First Principles

Build attention from the ground up, then understand modern architectures, caching, and efficient decoding.
Intermediate5 visual deep dives
1

Transformers: Attention, Architecture, Training, and Scaling

Transformers

84 min read
›
2

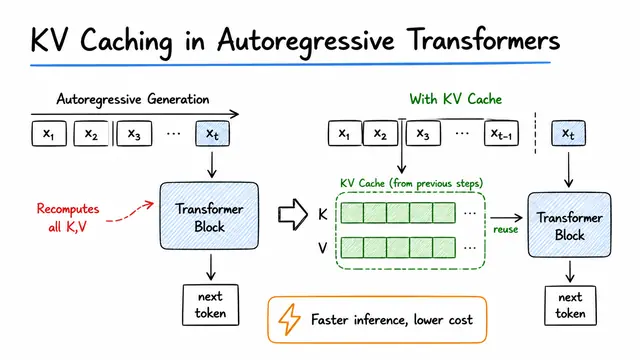
KV Caching in Autoregressive Transformers

KV Caching

45 min read
›
3

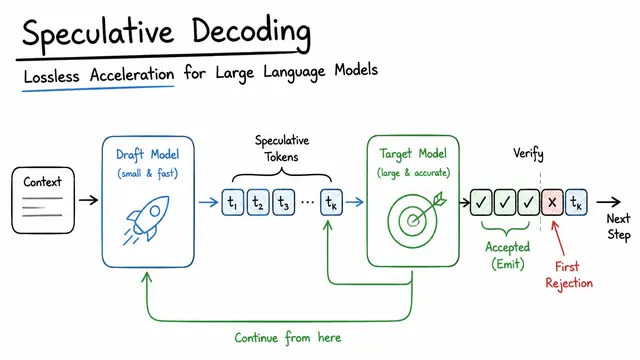
Speculative Decoding: Lossless Acceleration for Large Language Models

Speculative Decoding in LLM's

45 min read
›
4

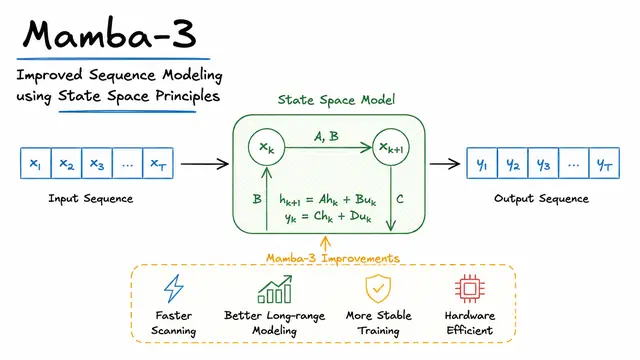
Mamba-3: Improved Sequence Modeling using State Space Principles

Mamba-3: Improved Sequence Modeling using State Space Principles

45 min read
›
5

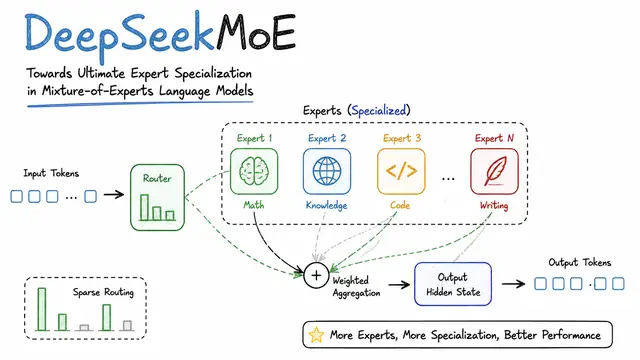
DeepSeekMoE: Towards Ultimate Expert Specialization in Mixture-of-Experts Language Models

MoE architecture for efficient LLM scaling via specialized experts

45 min read
›